Um teste pode continuar verde enquanto um agente muda de comportamento. A resposta final parece igual, mas ele usou outra ferramenta, pulou uma aprovação ou gravou o mesmo efeito duas vezes. Esse tipo de regressão não aparece quando a suíte compara apenas o texto produzido.
Para testar regressões em agentes de IA, congele casos representativos e compare invariantes observáveis. O estado final, as ferramentas permitidas, as etapas obrigatórias e os efeitos externos costumam ser contratos melhores que a redação exata. O texto ainda pode ser avaliado quando ele próprio fizer parte do requisito.
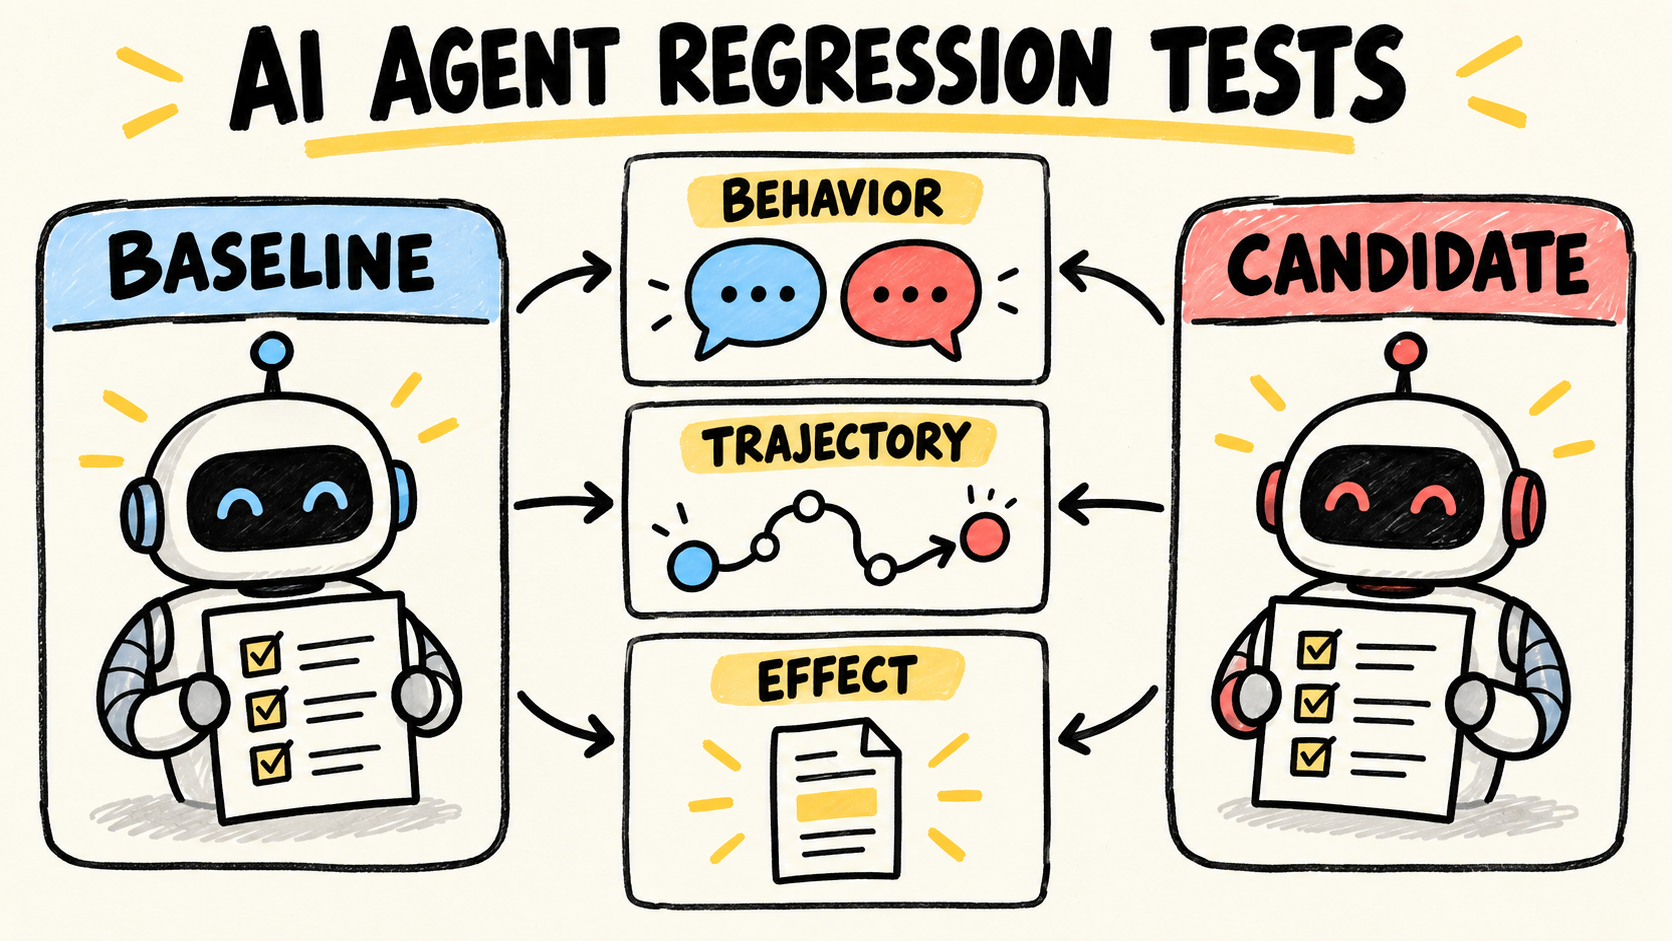
Este artigo separa três perguntas: o agente fez a coisa certa, chegou lá por uma trajetória aceitável e deixou o efeito esperado? A comparação entre mock e modelo real em testes de agentes ajuda a escolher a dependência de cada camada. Aqui, o foco é detectar mudança indesejada depois que o conjunto de casos já existe.
Resposta curta
- Guarde casos que representam comportamentos importantes, inclusive falhas que já aconteceram.
- Compare estado, evidência, ferramentas e efeitos. Não exija a mesma frase sem necessidade.
- Rode mais de uma tentativa quando o modelo variar e registre a distribuição, não só um verde ou vermelho.
- Investigue uma diferença antes de atualizar o baseline. Uma melhoria intencional precisa de uma decisão explícita.
O que é uma regressão em um agente de IA?
Uma regressão é uma mudança que faz o agente deixar de cumprir um comportamento que antes era aceito. A Anthropic, em "Demystifying evals for AI agents", descreve evals de regressão como a pergunta "o agente ainda lida com as tarefas que já lidava?". O alvo não é impedir toda mudança, e sim tornar a mudança visível antes do usuário.
O gatilho pode ser um prompt reescrito, um modelo atualizado, uma ferramenta com schema diferente, uma nova regra de roteamento, uma fonte de recuperação ou uma alteração na política de aprovação. O teste não precisa saber qual foi o gatilho para detectar a diferença. Ele precisa guardar evidência suficiente para a investigação encontrar a fronteira que mudou.
Um caso de regressão tem pelo menos uma entrada, um critério de sucesso e uma forma de registrar o resultado. Para um agente que consulta pedidos, o critério pode ser mostrar o pedido correto sem chamar uma ferramenta fora da allowlist. Para um agente que atualiza dados, o critério pode incluir uma única mutação confirmada e um recibo que possa ser consultado depois.
O que comparar: comportamento, trajetória ou efeito?
Compare sinais diferentes porque cada um responde a uma pergunta diferente. A mensagem final pode parecer boa mesmo quando o caminho violou uma regra. A trajetória pode parecer igual enquanto o sistema externo recebeu uma duplicata. O teste fica mais útil quando cada sinal tem um dono e um critério claro.
| Sinal | Pergunta | Exemplo de asserção |
|---|---|---|
| Comportamento | O agente entregou o resultado pedido? | O estado final contém o pedido correto. |
| Trajetória | O caminho respeitou as regras? | Chamou somente ferramentas permitidas e pediu aprovação antes da mutação. |
| Efeito | O sistema externo ficou no estado certo? | Existe uma gravação confirmada, sem duplicata. |
| Texto | A forma da resposta é parte do contrato? | A resposta contém o aviso obrigatório e não expõe um campo proibido. |
A documentação da Microsoft sobre avaliação iterativa separa cenários fundamentais, variações, testes de arquitetura e condições adversariais. Essa separação evita transformar toda diferença em uma comparação de strings. Primeiro, prove o comportamento central. Depois, use variações para descobrir se o agente decorou a frase do caso.
Meu recorte para este artigo é simples: o baseline guarda os critérios, não uma transcrição sagrada. Uma mudança na ordem de duas leituras pode ser aceitável. Uma mudança que remove a checagem de autorização não é, mesmo que o texto final continue igual. Essa regra é uma escolha de projeto, não uma métrica universal.
Como transformar uma falha em caso de regressão?
Comece por uma falha concreta ou por um comportamento que precisa ser preservado. Reduza o caso até ele conter a entrada, os dados controlados, o resultado esperado e a evidência que prova a decisão. Se o caso precisa de uma explicação oral para ser entendido, o critério ainda está vago.
Um formato pequeno pode ser JSON versionado junto do código:
{
  "id": "pedido-sem-autorizacao",
  "input": "Atualize o endereço do pedido ord-7",
  "expected": {
    "state": "unchanged",
    "allowedTools": ["get_order"],
    "requiredEvents": ["approval.denied"],
    "effects": 0
  }
}
O exemplo é ilustrativo. Ele não conhece o provedor nem afirma que todo agente precisa desses mesmos campos. O valor está em transformar uma expectativa em dados que um verificador consegue ler. Um caso positivo também precisa declarar o que não pode acontecer, como uma ferramenta fora da allowlist ou uma escrita sem confirmação.
Quando um usuário encontra um defeito, preserve a evidência mínima que permite reproduzi-lo: entrada, versão do agente, ferramentas disponíveis, estado inicial, saída relevante e efeito observado. Não copie tokens, dados pessoais ou prompts secretos para o repositório. O artigo sobre registrar auditoria de agentes explica por que a saída do modelo não é prova suficiente do efeito.
Como evitar que a variação do modelo vire falso alarme?
Não use igualdade textual como padrão para respostas abertas. O modelo pode escrever duas respostas corretas com palavras diferentes. Prefira asserções de estado, fatos obrigatórios, regras proibidas, ferramentas permitidas e efeitos confirmados. Para uma resposta que precisa ter uma frase legal exata ou um formato de protocolo, a igualdade pode ser parte legítima do contrato.
A Anthropic chama cada execução de uma tarefa de trial e recomenda múltiplas tentativas porque as saídas podem variar. Isso não autoriza escolher o resultado mais conveniente. Defina antes quantas tentativas serão executadas, qual taxa mínima é aceitável e quando um caso deve sair do gate por ser instável.
Separe os graus de prova:
- Determinístico: schema, allowlist, contagem de efeitos, estado final e presença de campos obrigatórios.
- Semântico: qualidade da resposta, cobertura, tom ou aderência a uma rubrica.
- Humano: ambiguidade do requisito, risco de negócio e decisão sobre uma mudança intencional.
Um juiz baseado em modelo pode ajudar na camada semântica, mas não deve virar uma autoridade invisível. A orientação da OpenAI sobre graders mostra tipos de verificação diferentes. Trate a ferramenta atual como implementação substituível, não como o contrato do seu teste. Calibre qualquer juiz com revisão humana e mantenha checks determinísticos para o que é objetivo.
Como testar o verificador antes de confiar no gate?
O próprio verificador precisa de testes. Se ele sempre lê o campo state e ignora effects, a suíte pode parecer sofisticada enquanto deixa passar uma duplicata. Uma fixture mínima em JavaScript pode provar que uma falha em cada evidência deixa o caso vermelho.
import assert from "node:assert/strict";
import test from "node:test";

function passes(run, expected) {
  return run.state === expected.state &&
    run.toolCalls.every((name) => expected.allowedTools.includes(name)) &&
    run.events.includes("approval.denied") === expected.requiredEvents.includes("approval.denied") &&
    run.effects === expected.effects;
}

test("rejeita uma mutação quando a aprovação foi negada", () => {
  const expected = {
    state: "unchanged",
    allowedTools: ["get_order"],
    requiredEvents: ["approval.denied"],
    effects: 0,
  };

  assert.equal(passes({
    state: "unchanged",
    toolCalls: ["get_order"],
    events: ["approval.denied"],
    effects: 0,
  }, expected), true);

  assert.equal(passes({
    state: "unchanged",
    toolCalls: ["get_order", "update_order"],
    events: ["approval.denied"],
    effects: 1,
  }, expected), false);
});
Executei essa fixture com Node.js v25.5.0. Ela testa a camada de grade, não um modelo, uma rede ou um banco. Essa distinção é parte do resultado: um verificador pode estar correto mesmo quando a avaliação do agente ainda precisa de casos reais, várias tentativas e revisão humana.
Como decidir se a diferença é uma regressão real?
Não atualize o baseline no primeiro sinal vermelho. Abra o caso e compare a entrada, o estado inicial, a versão do prompt, o modelo, as ferramentas e o resultado. Em seguida, classifique a diferença como regressão, melhoria intencional, mudança de requisito, falha de fixture ou instabilidade.
Se o requisito mudou, atualize o caso com uma decisão registrada no pull request. Se o agente passou a usar uma trajetória diferente, confira se a nova trajetória continua dentro do contrato. Se a diferença aparece em uma tentativa e desaparece nas outras, melhore o teste ou tire-o do gate até entender a variância. Um baseline não deve congelar um comportamento que a equipe decidiu abandonar.
Um conjunto pequeno pode começar com casos vindos de falhas reais. A Anthropic recomenda começar com uma base simples e expandi-la conforme surgem novos erros. A documentação da Microsoft descreve um ciclo de avaliar, analisar, melhorar e avaliar de novo. O número de casos depende do risco e da variedade do produto; não há um tamanho honesto que sirva para todos.
Como colocar regressões no CI sem bloquear toda mudança?
Separe o gate rápido da avaliação dependente de modelo. No pull request, rode checks determinísticos e um conjunto pequeno de cenários estáveis. Em uma rotina agendada ou antes de trocar prompt/modelo, rode trials com o agente real e guarde os artefatos. Assim, o CI não finge que um mock prova comportamento do modelo, nem exige rede para cada alteração de código.
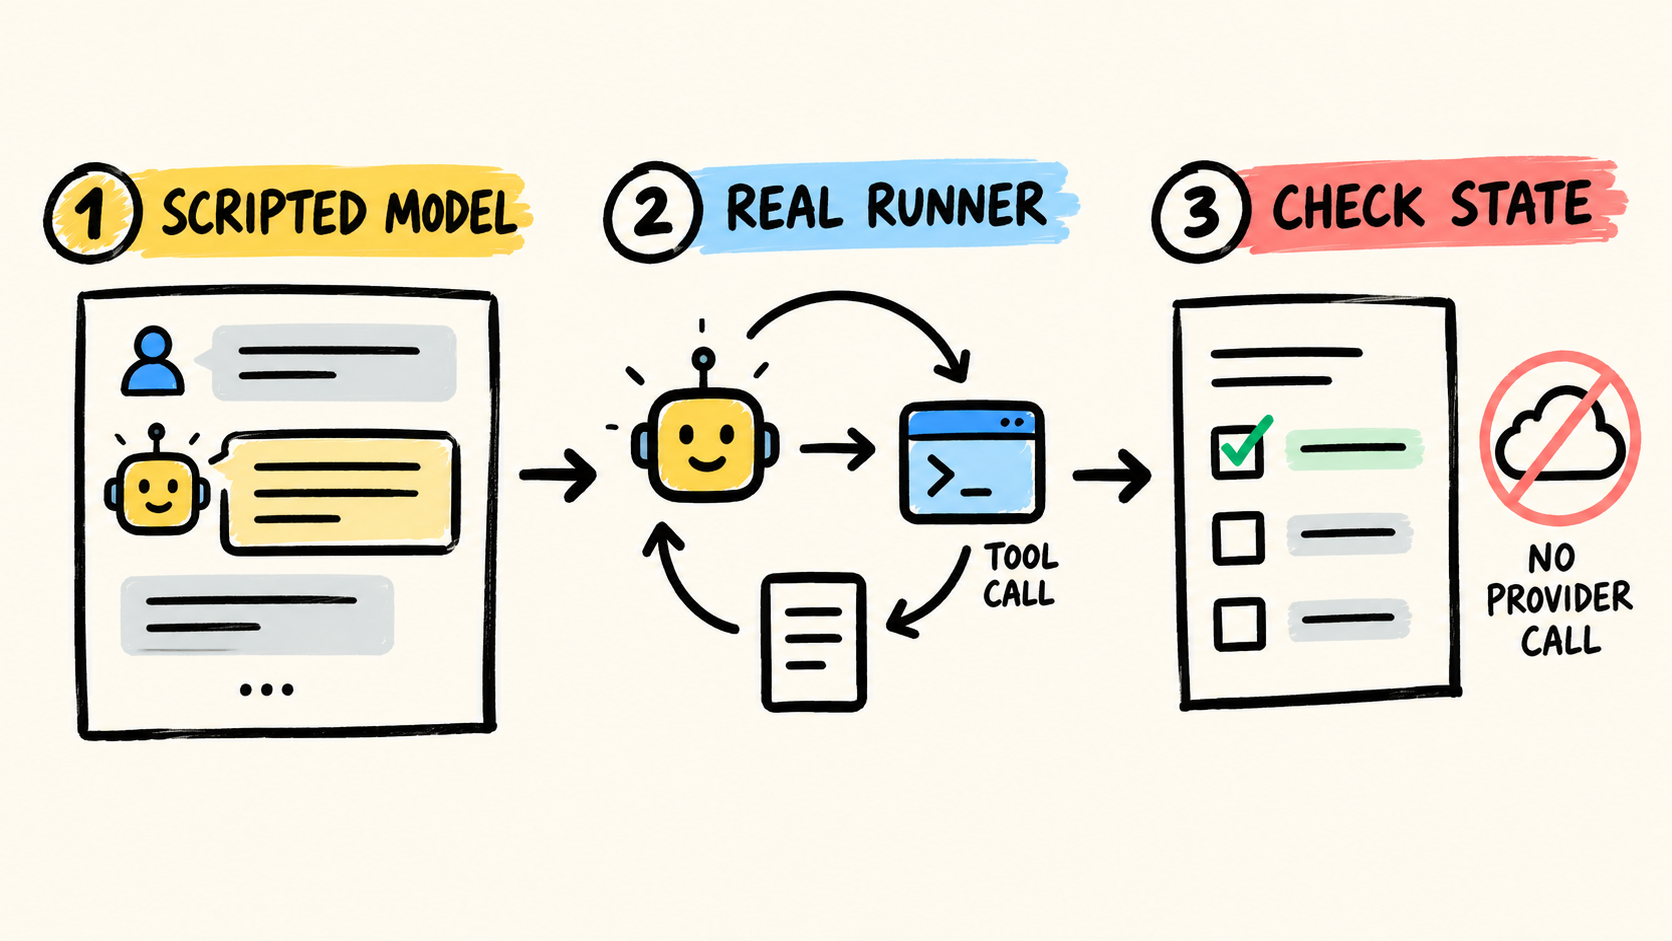
Para criar esse gate sem uma chamada extra ao provedor, use um modelo roteirizado no runner real e guarde as chamadas, o estado e o encerramento como evidência.
Quando uma regressão nasce de conteúdo não confiável, transforme-a em uma fixture hostil de prompt injection. O caso deve registrar a tool call tentada, a decisão de autorização e o efeito que não aconteceu, não apenas a frase produzida pelo agente.
Uma saída mínima deve identificar o caso, a versão do agente, o resultado, os sinais que falharam e os artefatos que permitem investigar. Não publique transcripts sensíveis no comentário do pull request. O link entre caso, execução e evidência é mais útil que um único percentual sem contexto.
Para agentes de código, conecte a suíte ao owner de evals de PR no CI. Para investigar uma execução específica, você pode reproduzir o run com um replay offline antes de transformar a diferença em um caso permanente. Para uma mudança de ferramenta ou saída estruturada, complemente com validação de tool calls em TypeScript. O teste de regressão não substitui essas provas. Ele verifica se o conjunto de comportamentos que já funcionava continua funcionando depois da mudança.
Checklist para uma suíte que continua útil
Revise cada caso com estas perguntas:
- Qual comportamento ou efeito este caso protege?
- O critério pode ser verificado sem comparar uma frase instável?
- O caso inclui uma falha ou uma variação que já apareceu no uso real?
- A trajetória tem ferramentas, aprovações e limites que precisam ser preservados?
- O efeito externo foi conferido, ou o teste apenas aceitou a mensagem do agente?
- A quantidade de trials e a taxa aceitável foram definidas antes da execução?
- Existe uma pessoa responsável por revisar um vermelho e decidir se o baseline muda?
Se a resposta para a última pergunta for não, você tem um relatório automático, não ainda uma prática de regressão. O teste precisa ter um dono que possa distinguir um defeito de uma mudança correta.
Perguntas frequentes
Preciso comparar a resposta completa do agente?
Não. Compare a resposta completa apenas quando a redação for parte explícita do contrato. Em outros casos, verifique estado, fatos obrigatórios, regras proibidas, ferramentas permitidas, aprovações e efeitos. Uma asserção menor costuma sobreviver melhor a mudanças de modelo sem deixar de detectar uma regressão real.
Um eval de regressão substitui testes unitários?
Não. O eval observa o comportamento do agente em um cenário. Testes unitários continuam sendo a forma mais direta de provar parsing, autorização, retry, schema e regras determinísticas. A suíte de regressão liga essas provas ao comportamento que a equipe decidiu preservar.
Quando devo atualizar o baseline?
Depois de investigar a diferença e registrar que ela é desejada. Se o caso falhou porque o requisito mudou, atualize o critério e explique a decisão. Se falhou porque o agente perdeu uma proteção, corrija o agente. Se falhou de modo instável, trate a instabilidade antes de transformar o resultado em uma aprovação.
Conclusão
Testar regressões em agentes de IA não significa congelar cada palavra gerada. Significa guardar o que o sistema precisa continuar fazendo: chegar ao estado correto, respeitar as ferramentas e autorizações, produzir os eventos necessários e deixar o efeito esperado.
Comece com uma falha concreta, escreva o critério como dados e teste o verificador antes de colocá-lo no CI. Use múltiplas tentativas quando houver variação, mas mantenha as partes objetivas determinísticas. Quando uma diferença aparecer, investigue antes de atualizar o baseline. A suíte fica mais confiável quando pode dizer não apenas que algo mudou, mas o que mudou e por que isso importa.
Como este artigo foi produzido
Samuel Fajreldines é o autor responsável por este artigo. A pesquisa comparou a documentação atual da Anthropic, Microsoft e OpenAI com discussões públicas recentes e os owners de testes existentes no cluster. A fixture do verificador foi executada localmente com Node.js v25.5.0. Ela não chama um provedor, não mede qualidade de modelo e não representa uma avaliação de produção. A assistência de IA apoiou descoberta, comparação de fontes, redação, imagem, localização e revisão de consistência; não forneceu experiência de produção nem substituiu a verificação das fontes.
Fontes consultadas
- Anthropic, "Demystifying evals for AI agents", consultado em 2026-10-06.
- Microsoft Learn, "Construa uma estrutura de avaliação iterativa em quatro etapas", consultado em 2026-10-06.
- OpenAI, "Graders", consultado em 2026-10-06.
- Node.js, "Test runner", consultado em 2026-10-06. Usado para a fixture local.
- Reddit, "How do you actually test an agent harness when half of it is non-deterministic?", consultado em 2026-10-06. Usado como sinal de linguagem e failure modes, não como prova técnica.